


Forskere fra XPENG, Peking University, The University of Hong Kong og andre universiteter har udgivet GroundingPI, en model med omkring 4 mia. parametre, der skal finde ting i billeder og angive præcis, hvor de er. XPENG annoncerede modellen 4. november 2026. Koden og modelvægtene er frit tilgængelige sammen med forskningsartiklen.
XPENG skriver samtidig, at udgivelsen ikke er en meddelelse om, at modellen kommer i selskabets produkter, og at resultaterne fra simulering og offline-test ikke viser, at den er klar til kommerciel brug. Selve forskningsartiklen kalder arbejdet akademisk forskning, der ikke udtrykker XPENGs officielle holdning.
GroundingPI trænes uden robottens bevægelser
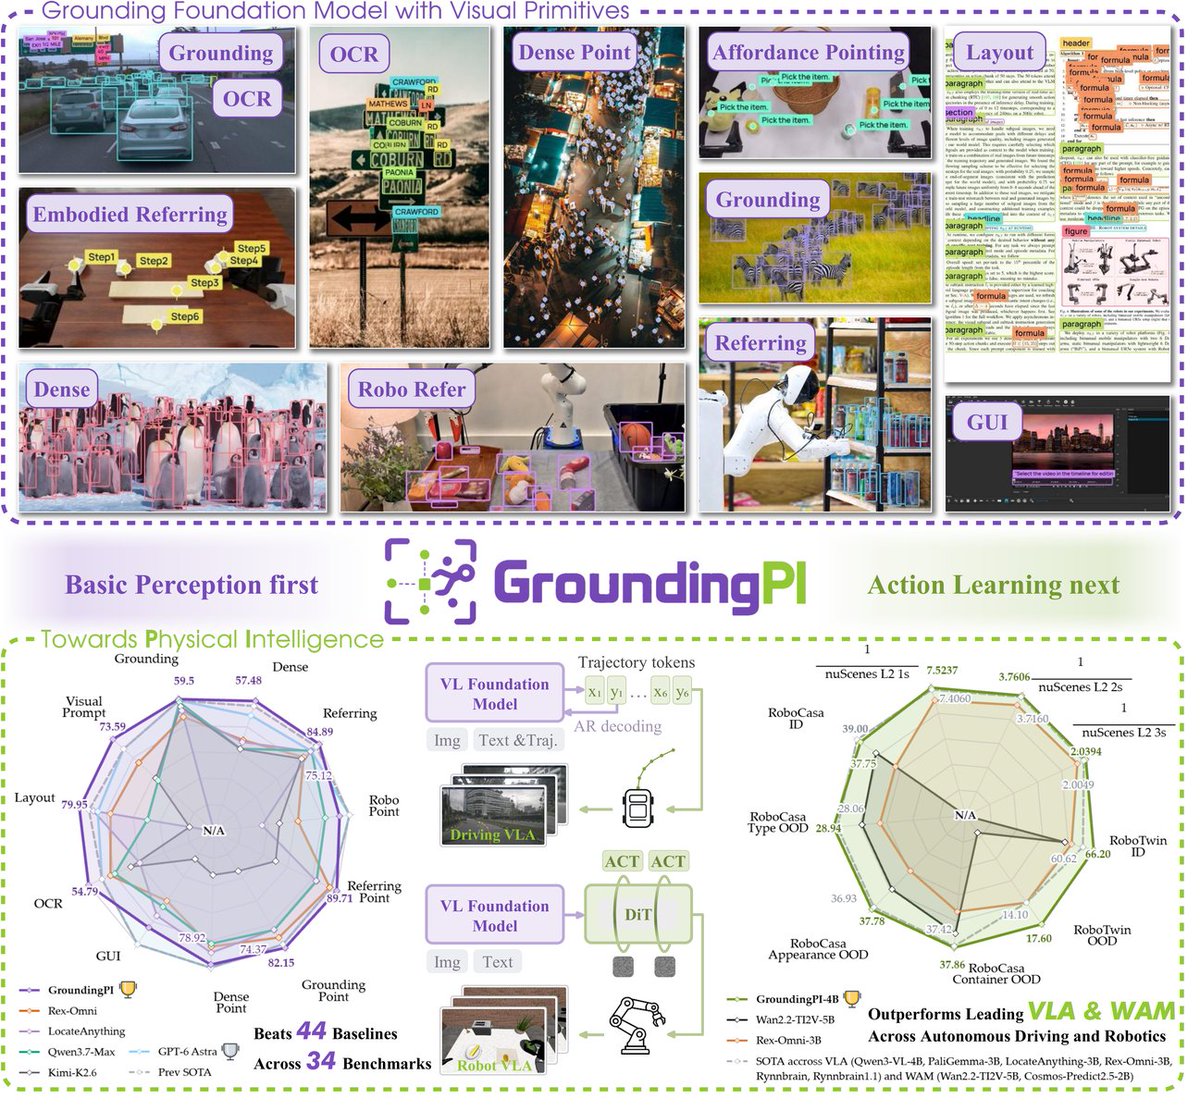
En robot kan ikke gribe en kop, hvis den ikke ved, hvor koppen er i billedet. Det er tanken bag GroundingPI, og derfor er modellen trænet uden robotdata med bevægelser, kun på data om at se og udpege. Træningsdataene dækker 11 kategorier, fra objektdetektion og tekstgenkendelse (OCR) til knapper på skærme og robotters placering af ting i rummet.
XPENGs eksempel er “håndtaget på koppen til højre”. Modellen skal pege både den rigtige kop og håndtaget ud med punkter eller bokse; svaret “der er en kop i billedet” er ikke nok. “Grounding” er netop det at forbinde ord med et bestemt område i billedet, og “PI” står for Physical Intelligence.
I en robot er GroundingPI tænkt som synet i det hurtige system. Det, den ser, går videre til en separat model, der lærer bevægelserne. Opgaven forstås og planlægges stadig af en stor, generel model.
GroundingPI slår GPT-6 Astra samlet, men ikke i alle kategorier
Forskerne sammenlignede GroundingPI med 44 andre modeller på 34 offentlige benchmarks. Med de 11 kategorier vægtet lige får GroundingPI 73,68 og OpenAIs GPT-6 Astra 71,54. XPENG understreger, at tallet kun måler perception, ikke generel intelligens eller ræsonnement.
XPENGs diagram viser GroundingPI øverst i otte af de 11 kategorier. I de sidste tre ligger en anden model foran: knapper og felter på skærme (92,58 mod 78,92), punkter i tætte motiver (76,10 mod 74,37) og punkter til robotopgaver (81,08 mod 75,12).
Færre demonstrationer i simulering
Resten er test i simulering og på optagne data. I RoboCasa-GR1 nåede robotsystemer med GroundingPI som syn en højere succesrate med 50 % af demonstrationsdataene, end sammenligningsmodellerne nåede med 75 %. I RoboTwin 2.0 klarede den sig bedre end de gængse synsmodeller i fire situationer, robotten ikke var trænet til. På nuScenes, et datasæt optaget med selvkørende biler, beregnede den bilens bane fremad med en gennemsnitlig afvigelse på 0,296 meter fra den optagne bane.
For en XPENG-ejer ændrer GroundingPI intet i dag. XPENG kalder modellen en vigtig byggesten i koncernens Physical AI, men nævner ingen bil eller robot, den skal ind i. Hvordan XPENGs model til assisteret kørsel i bilerne er bygget, står i vores artikel om VLA.

Billeder: XPENG
Kilder
XPENG Global på X, 4. november 2026: GroundingPI slår GPT-6 Astra i samlede perceptionsbenchmarks